
Einsatzplaner — Comparativo de Schedulers (IA vs. Algoritmo Clássico)
straussbastian/Einsatzplanerauswertung
Comparativo científico: OR-Tools vs. LLM em otimização de rotas com tempo real
Ver no GitHubExperimento rigoroso comparando quatro estratégias de escalonamento para VRPTW (Vehicle Routing Problem with Time Windows): heurística determinística, OR-Tools clássico, LLM direto e híbrido IA-guiado. Executa 30 seeds com perturbações intraday estocásticas em cenário realista de serviço técnico, revelando que OR-Tools supera marginalmente abordagens baseadas em LLM.
Instalação
npx convez-ai straussbastian/Einsatzplanerauswertung1 comando no terminal: detecta o formato do repositório (marketplace ou plugin avulso) e instala via Claude Code. Requer Node 18+ e o Claude Code instalado.
Métricas
Casos de uso
- Benchmarking de solvers de roteamento em domínios com restrições complexas
- Avaliação de quando LLM-augmentation traz ou não ganho em otimização combinatória
- Estudo de caso: replanejamento dinâmico sob perturbações intraday
- Validação metodológica com tamanho de amostra adequado (30 seeds vs. 10)
Veredito

Trabalho metodologicamente sólido com transparência nas limitações. Maior valor está na lição aprendida sobre tamanho de amostra e na refutação honesta da hipótese hybrid — raro em papers que experimentam com LLM. Útil para quem questiona quando IA realmente melhora vs. quando é overhead.
README
A tradução para o português deste README ainda está na fila.
Einsatzplaner — KI vs. klassischer Algorithmus in der Tourenplanung
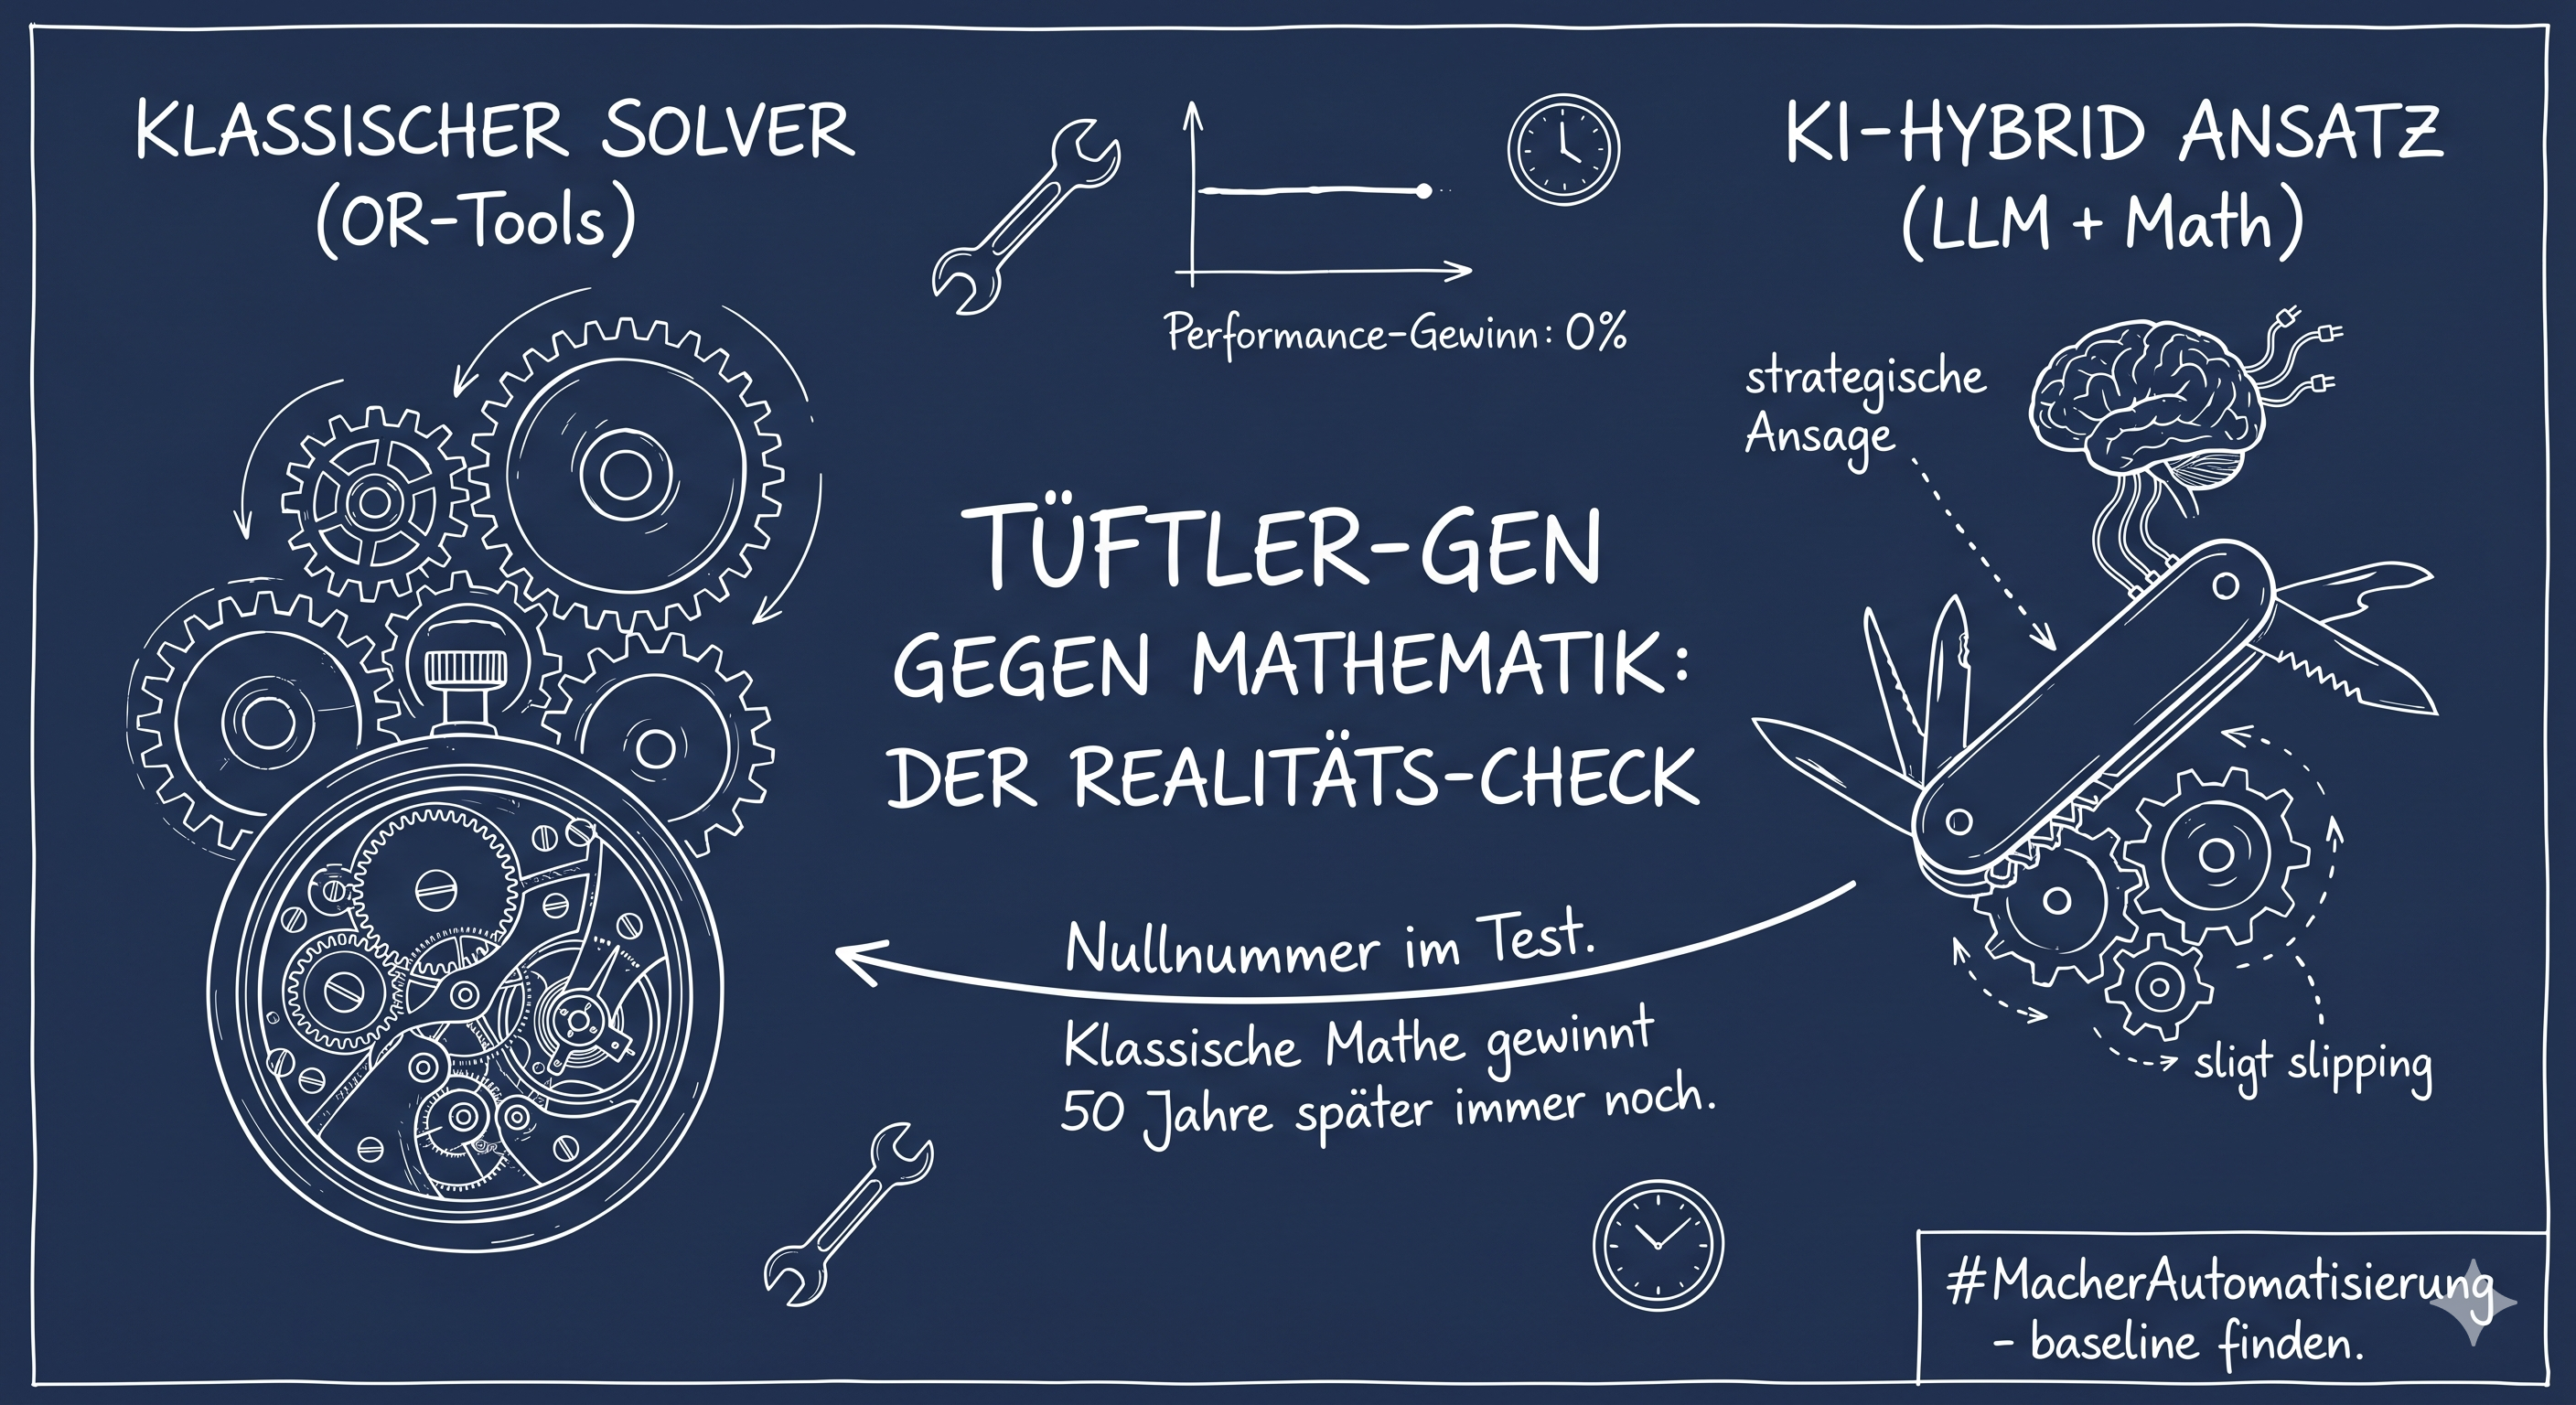
Ein Experiment zur Frage: Kann ein LLM-gestützter Scheduler einen klassischen VRPTW-Solver übertreffen — und wenn ja, wo?
Antwort der Arbeit, in einem Satz: In einer Domäne mit etabliertem algorithmischem Fundament (VRPTW, OR-Tools) ist ein vernünftig konstruierter klassischer Solver dem LLM-gestützten Hybrid durchgehend ebenbürtig oder marginal überlegen — über vier unabhängige Testsetups inklusive Skill-Heterogenität (30 Seeds) lässt sich keine Bedingung identifizieren, in der LLM-Augmentation einen statistisch signifikanten Performance-Vorteil liefert.
Ein Zwischenbefund aus einem 10-Seed-Pilotlauf zum Qualifikations-Constraint legte kurzzeitig einen ersten positiven Hybrid-Effekt nahe (+0.13 pp Completion). Der 30-Seed-Absicherungslauf reproduziert diese Richtung nicht — die nominelle Rangfolge dreht sich (OR-Tools-normal +0.55 pp vor Hybrid), bleibt aber selbst bei n=30 im Rauschen (p ≈ 0.3). Was die Absicherung tatsächlich zeigt: kein detektierbarer Effekt in beide Richtungen. Der Bericht dokumentiert beides und zieht daraus eine methodische Lesson Learned zur Seed-Größe.
📄 Auswertungen
Die zentralen Dokumente dieser Arbeit:
- 📊 Wissenschaftlicher Auswertungs-Report — Ausgangslage, Methodik, Verfahren, LLM-Prompts (wörtlich), alle drei Haupt-Ergebnisse (Multi-Profil, Replan, Replan+Context), Diskussion, Limitationen, Ausblick.
- 🔧 Technische Dokumentation — Projektstruktur, Datenmodell, Scheduler-Architektur, Replan-Infrastruktur, Benchmark-Workflow, Kennzahlen.
Inhalt
- Domain
- Vier Verfahren
- Kern-Ergebnisse
- Installation
- App starten
- Benchmark ausführen
- Projektstruktur
- Lizenz
Domain
Fiktiver Heizungsbaubetrieb in Oldenburg (Oldb.) mit 10 Servicetechnikern, die täglich 40–50 Wartungsaufträge im 30-km-Radius erledigen. Zu lösen: VRPTW (Vehicle Routing Problem with Time Windows) mit Priorisierung (Dringlichkeit, Notfälle, SLA-Fristen, Rollover-Count), Pausenpflicht (15 min Frühstück, 45 min Mittag), Zeitfenstern für Gewerbe- und Fixtermine und stochastischen Intraday-Störungen (Krankmeldung, Stau, Auftragsverlängerung, spontaner Notfall, Kundenabsage).
Vier Verfahren
| Verfahren | Ansatz | Stärke | Schwäche |
|---|---|---|---|
| Heuristik | Deterministische Greedy-Insertion mit Prio-Score | Sekundenschnell, keine Abhängigkeiten | Keine globale Optimierung, ~14 pp Completion unter den Solvern |
| OR-Tools VRPTW | Google OR-Tools mit Disjunction-Penalties, per-Vehicle Start-Nodes für Replan | Globale Optimierung, robust gegen Penalty-Variation | Deterministisch kalibriert, reagiert nicht auf Tageskontext |
| LLM-Direct | Claude Sonnet 4.6 macht Zuordnung + Reihenfolge via Tool-Use | Erklärt seine Strategie in natürlicher Sprache | Kombinatorisch schwächer, unterfüllt die Touren |
| Hybrid | LLM setzt pro Tag/Replan die Penalty-Gewichte, OR-Tools optimiert | Kontext-sensitive Kalibrierung ohne manuelle Regel | Kein messbarer Performance-Gewinn gegenüber statischer Kalibrierung |
Kern-Ergebnisse
Vier unabhängige Haupttests in einer Progression — alle vier widerlegen die Hybrid-Hypothese:
| Test | Setup | Ergebnis |
|---|---|---|
| Multi-Profil-Woche | 20 Seeds, 5 Tagesprofile Mo–Fr + stochastische Intraday-Events; vier statische Kalibrierungen + Hybrid | Alle fünf Varianten statistisch ununterscheidbar. Hybrid liefert keinen Performance-Vorteil. |
| Replan-Test | 10 Seeds, Intraday-Events triggern Scheduler-Replan | Replan hilft nur der Heuristik (+2.9 pp). Hybrid und OR-Tools verlieren beide leicht durch kleinteilige Replan-Zyklen. |
| Replan + Tagesverlauf-Kontext | 10 Seeds, Hybrid bekommt Tagesverlaufs-Info (wievielter Replan, Trigger-Event, Rest-Schicht pro Tech) | Kein Mittelwert-Gewinn gegenüber „Replan ohne Kontext". Einziger Effekt: Streuung sinkt (±2.43 → ±1.73). |
| Qualifikations-Constraint | 30 Seeds, 40 % Techniker mit Kälteschein, 20 % Aufträge erfordern ihn | Hybrid-Hypothese nicht bestätigt. 10-Seed-Pilotsignal (+0.13 pp Hybrid) bei 30 Seeds nicht reproduzierbar; die 30-Seed-Nominalrichtung (+0.55 pp OR-Tools) ist ebenfalls nicht signifikant (p ≈ 0.3). Netto: kein detektierbarer Effekt in beide Richtungen. |
Details, Tabellen und Interpretation in der wissenschaftlichen Auswertung.
Installation
git clone git@github.com:straussbastian/Einsatzplanerauswertung.git
cd Einsatzplanerauswertung
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
cp .env.example .env
# .env öffnen und ANTHROPIC_API_KEY eintragen (nur für LLM/Hybrid nötig)
App starten
Die interaktive Streamlit-Oberfläche läuft mit:
streamlit run app.py
Features:
- Tag-Modus: Plane einen einzelnen Tag mit frei gewähltem Scheduler, Gantt-Chart, Karte, Techniker-Übersicht.
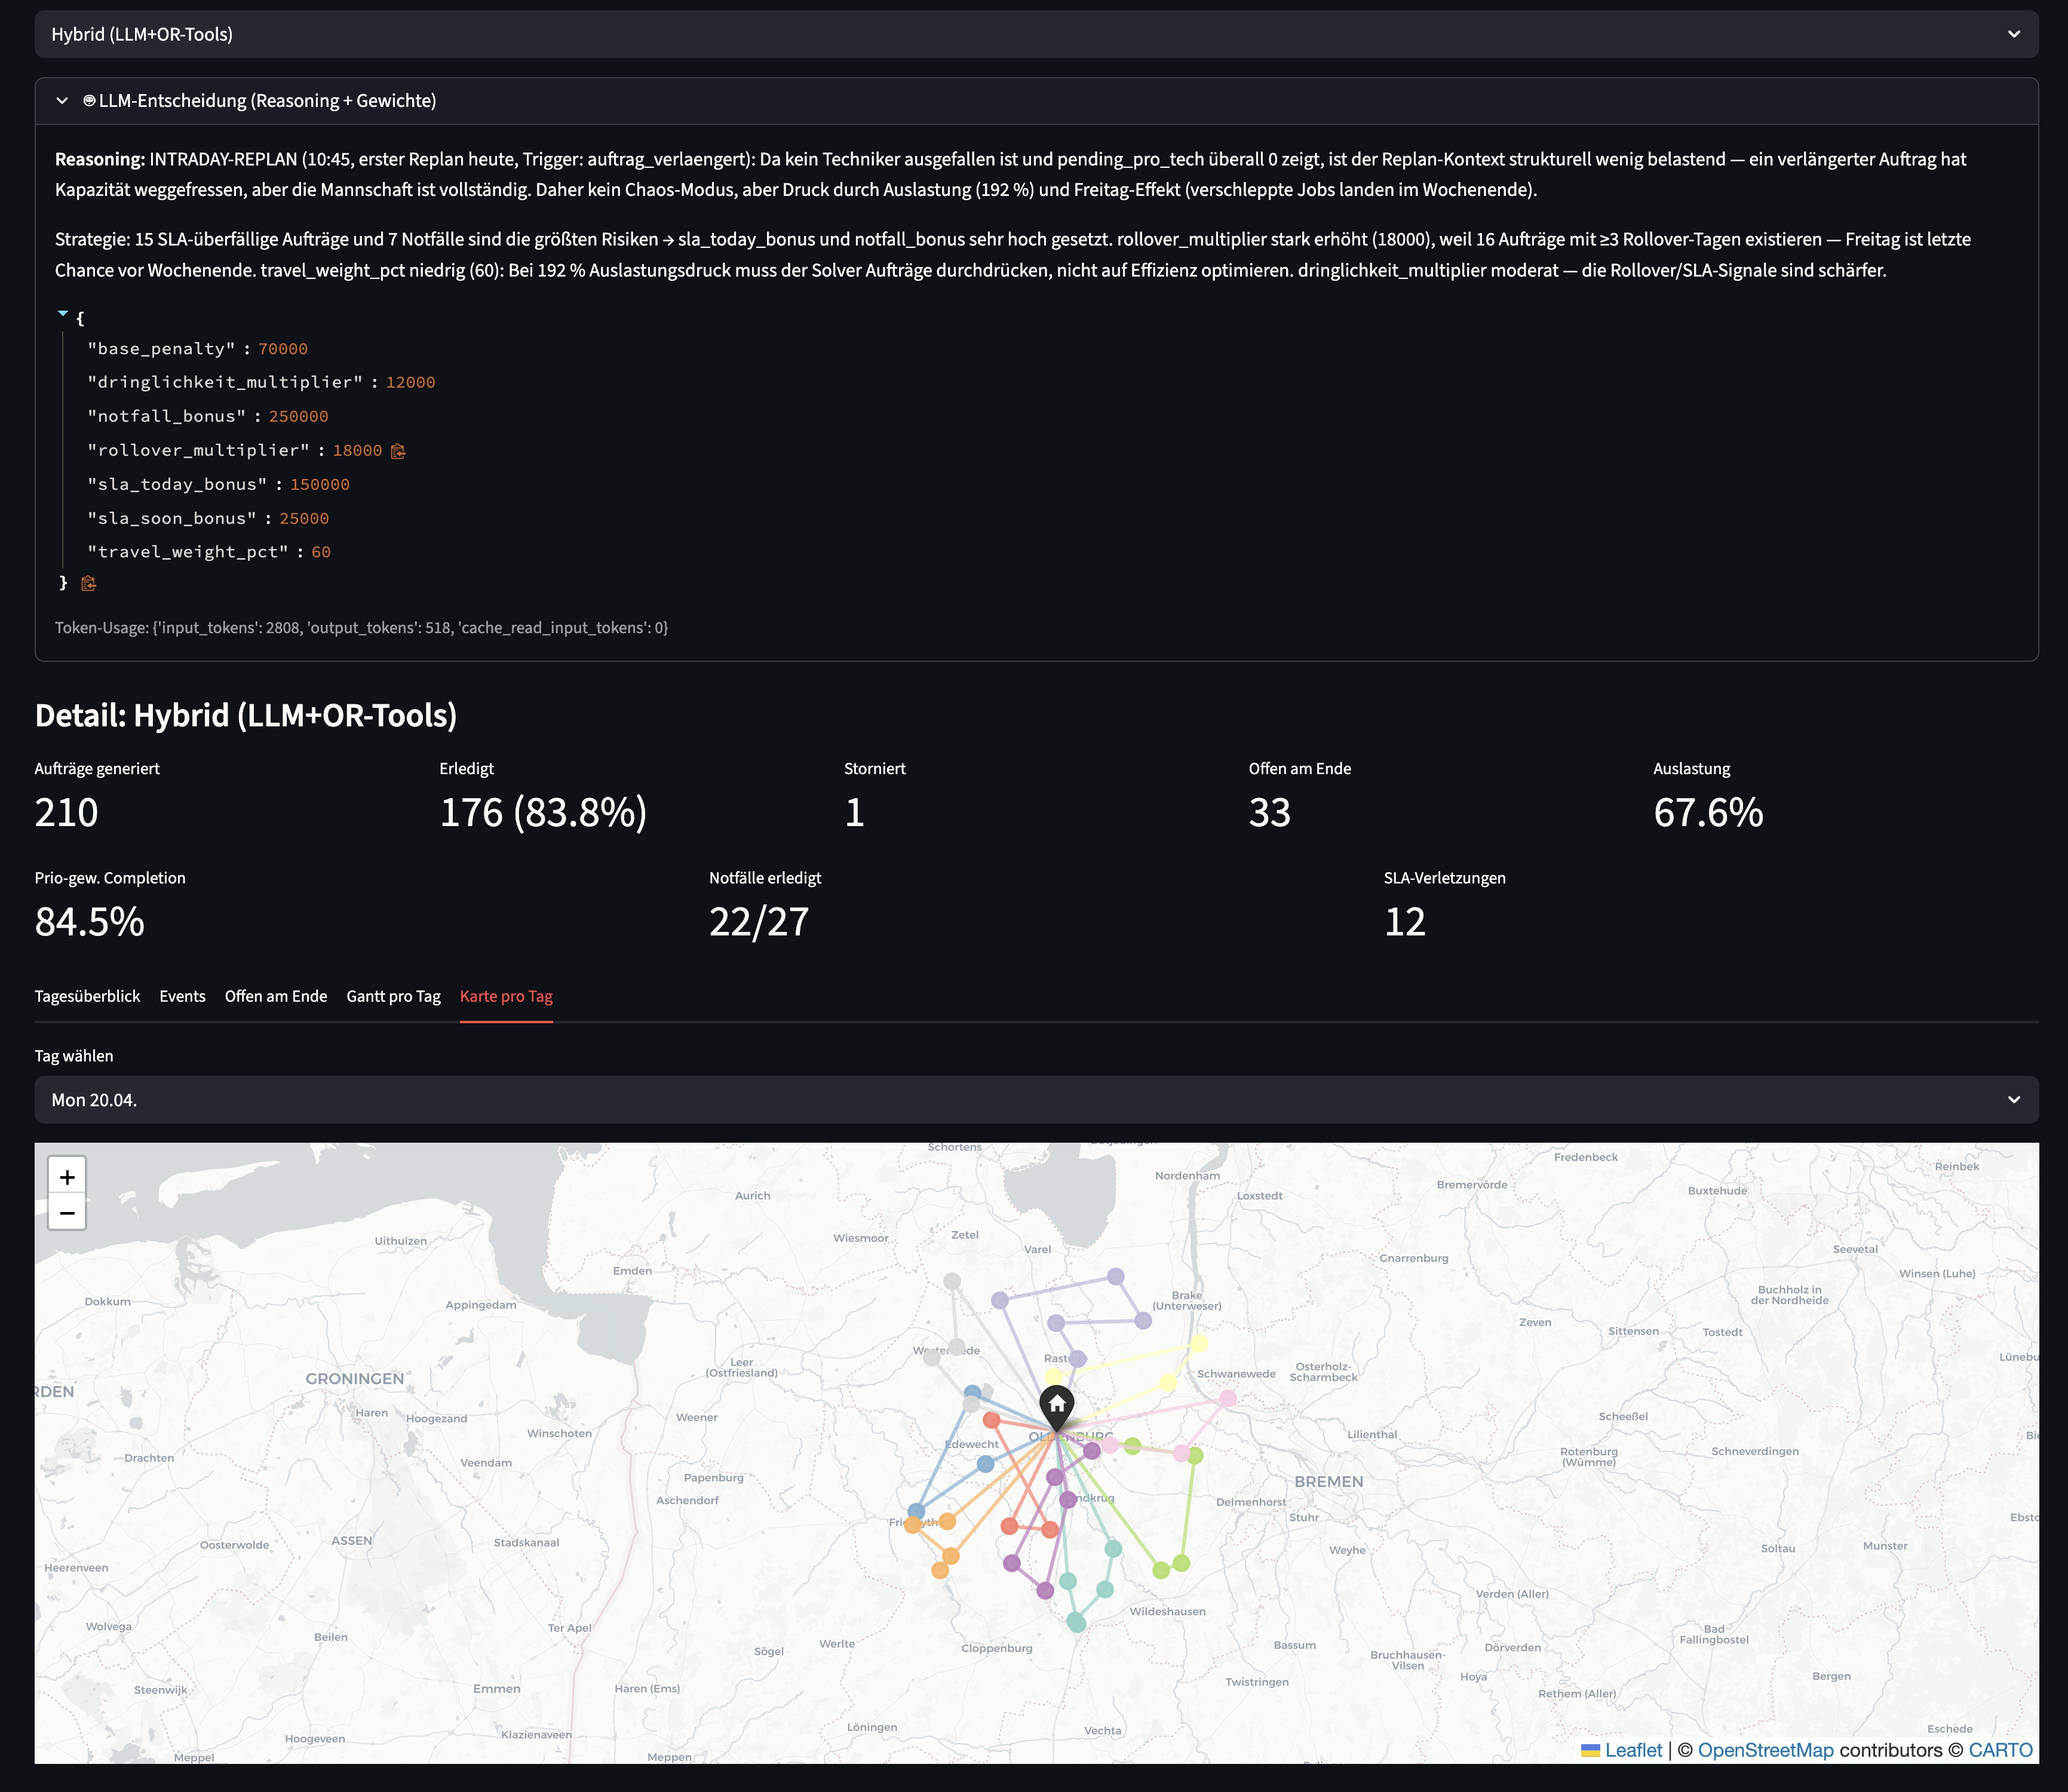
- Wochen-Modus: Fünf-Tage-Lauf mit Szenario-Auswahl, Intensitäts-Presets (Normal / Hochlast / Notfallwoche / SLA-Katastrophe / Chaos / Realistisch), Pro-Woche-Auftragsmenge. Zeigt Tagesüberblick, Events, Gantt pro Tag, Karte pro Tag, bei Hybrid das LLM-Reasoning + die gewählten Gewichte.
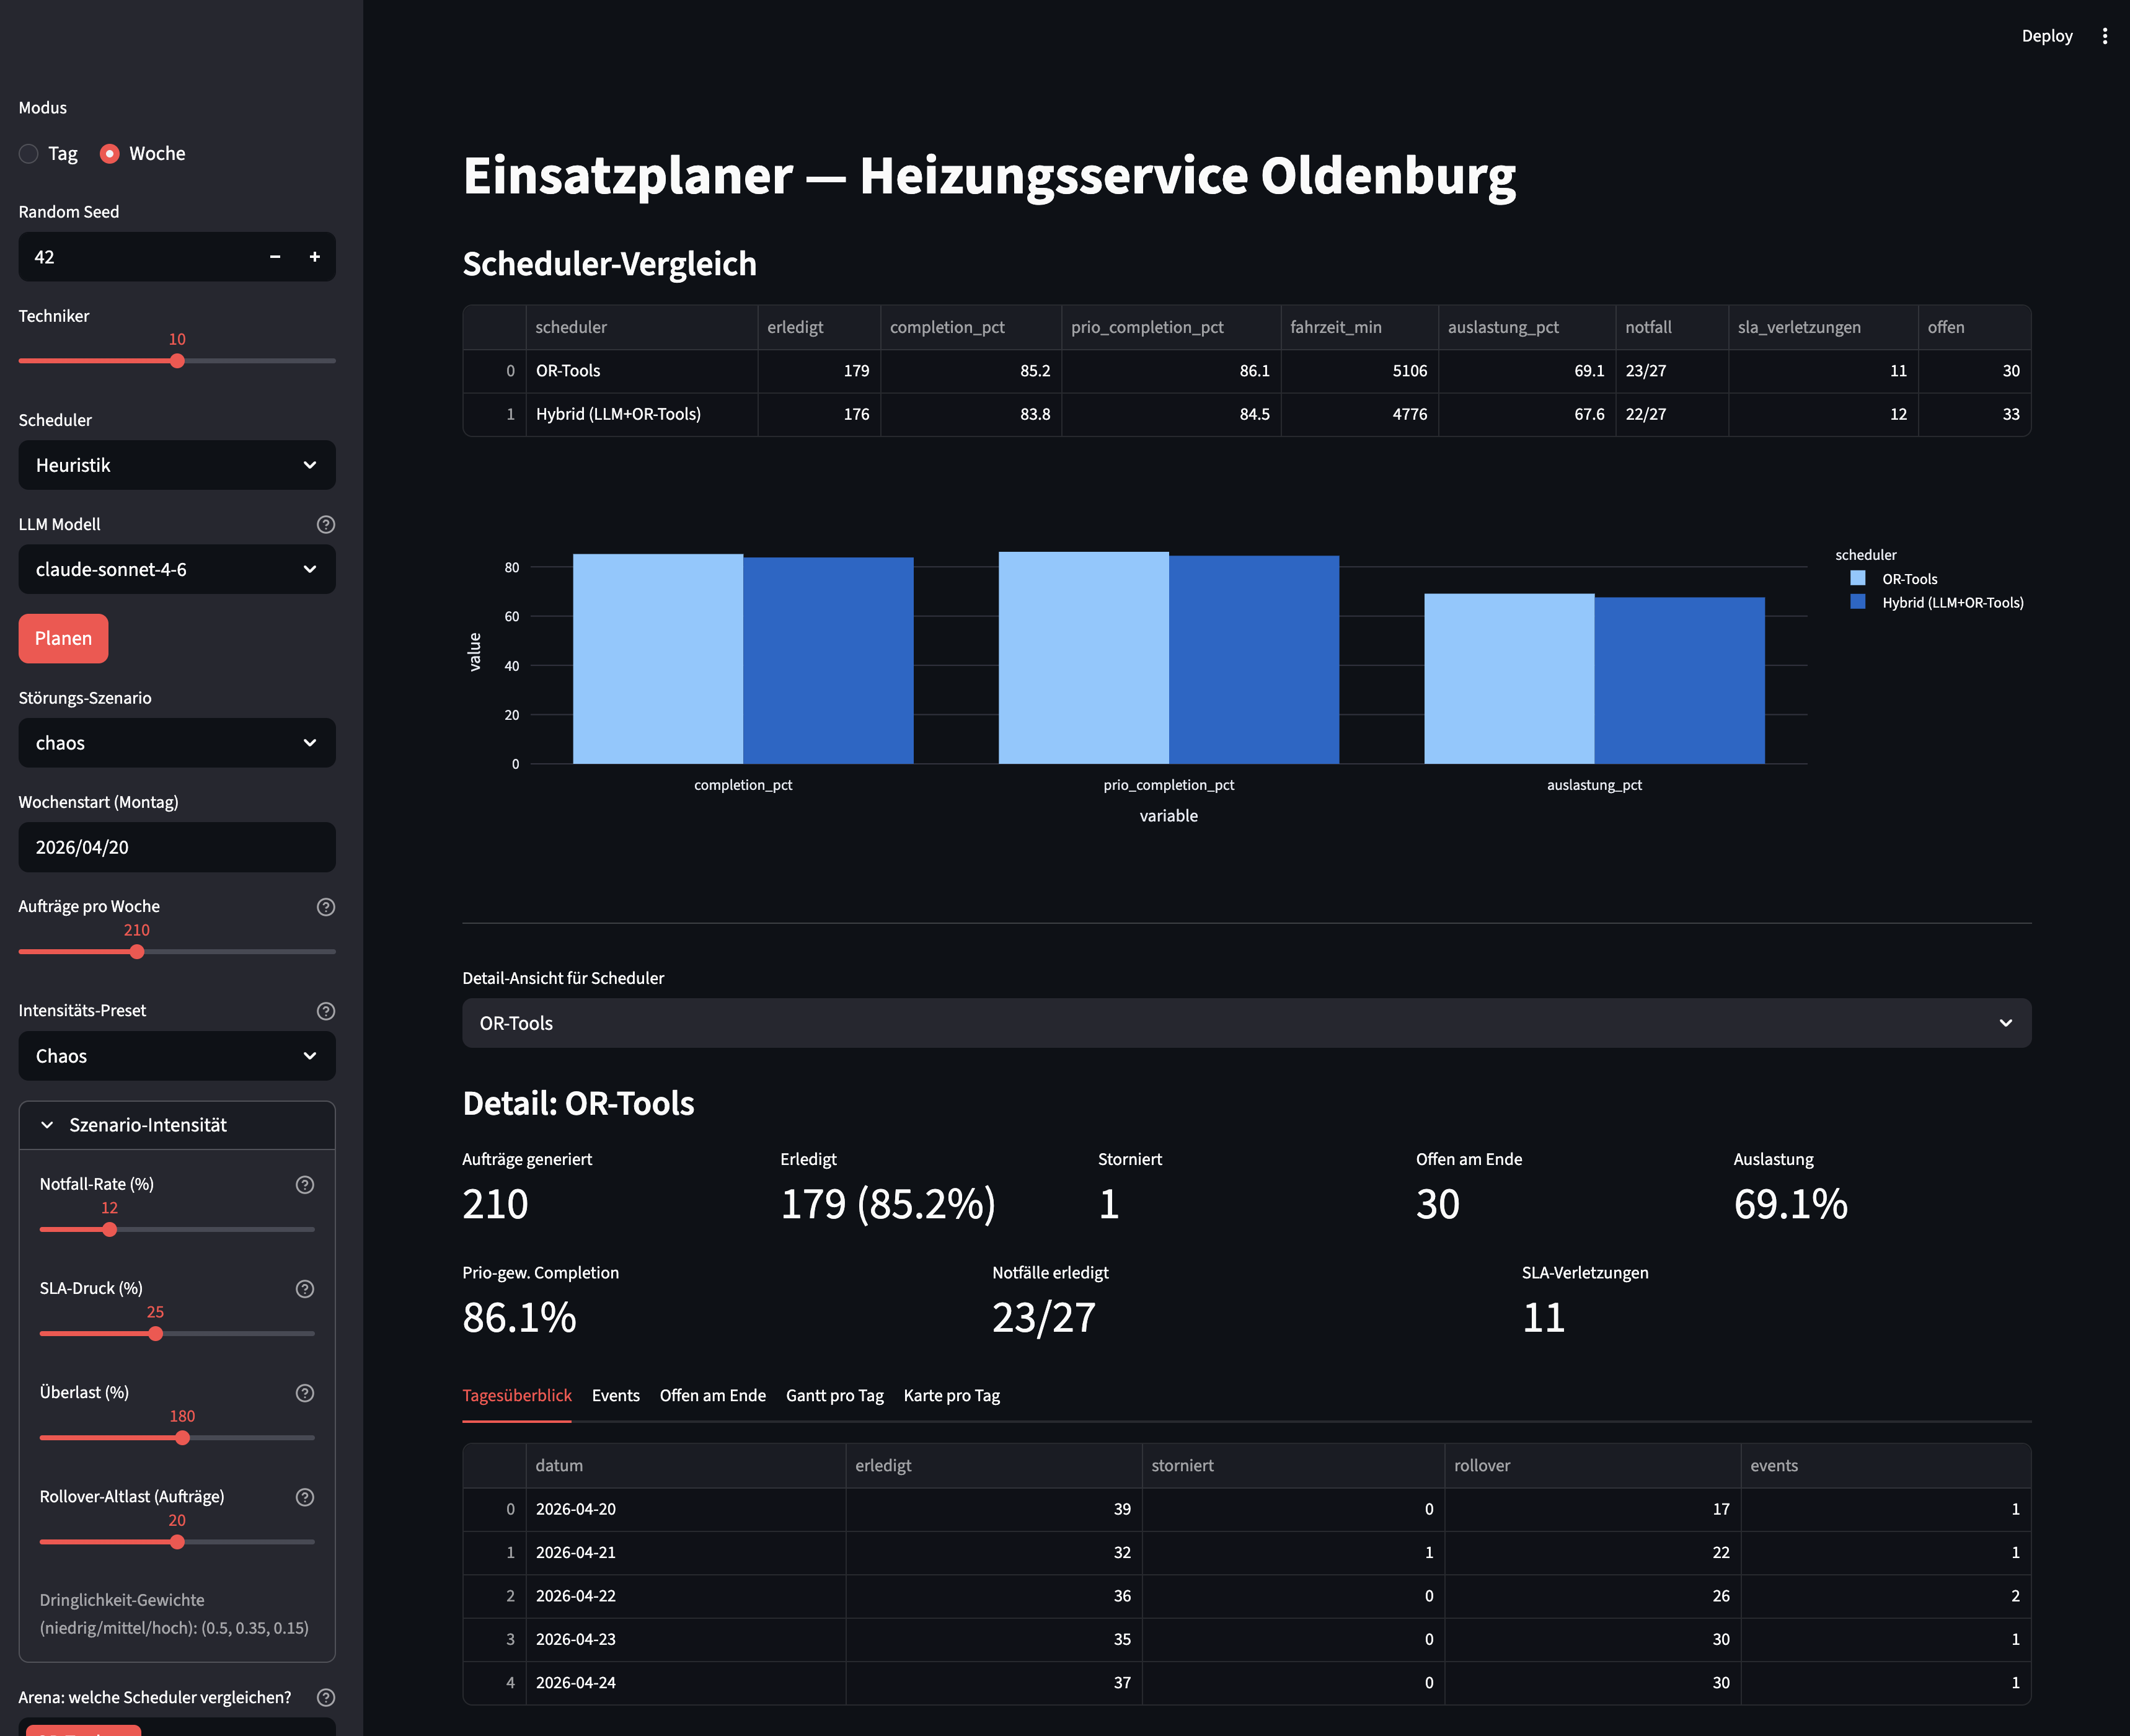
- Arena: Mehrere Scheduler parallel auf denselben Daten vergleichen, automatische Metrik-Tabelle und Balkendiagramme.
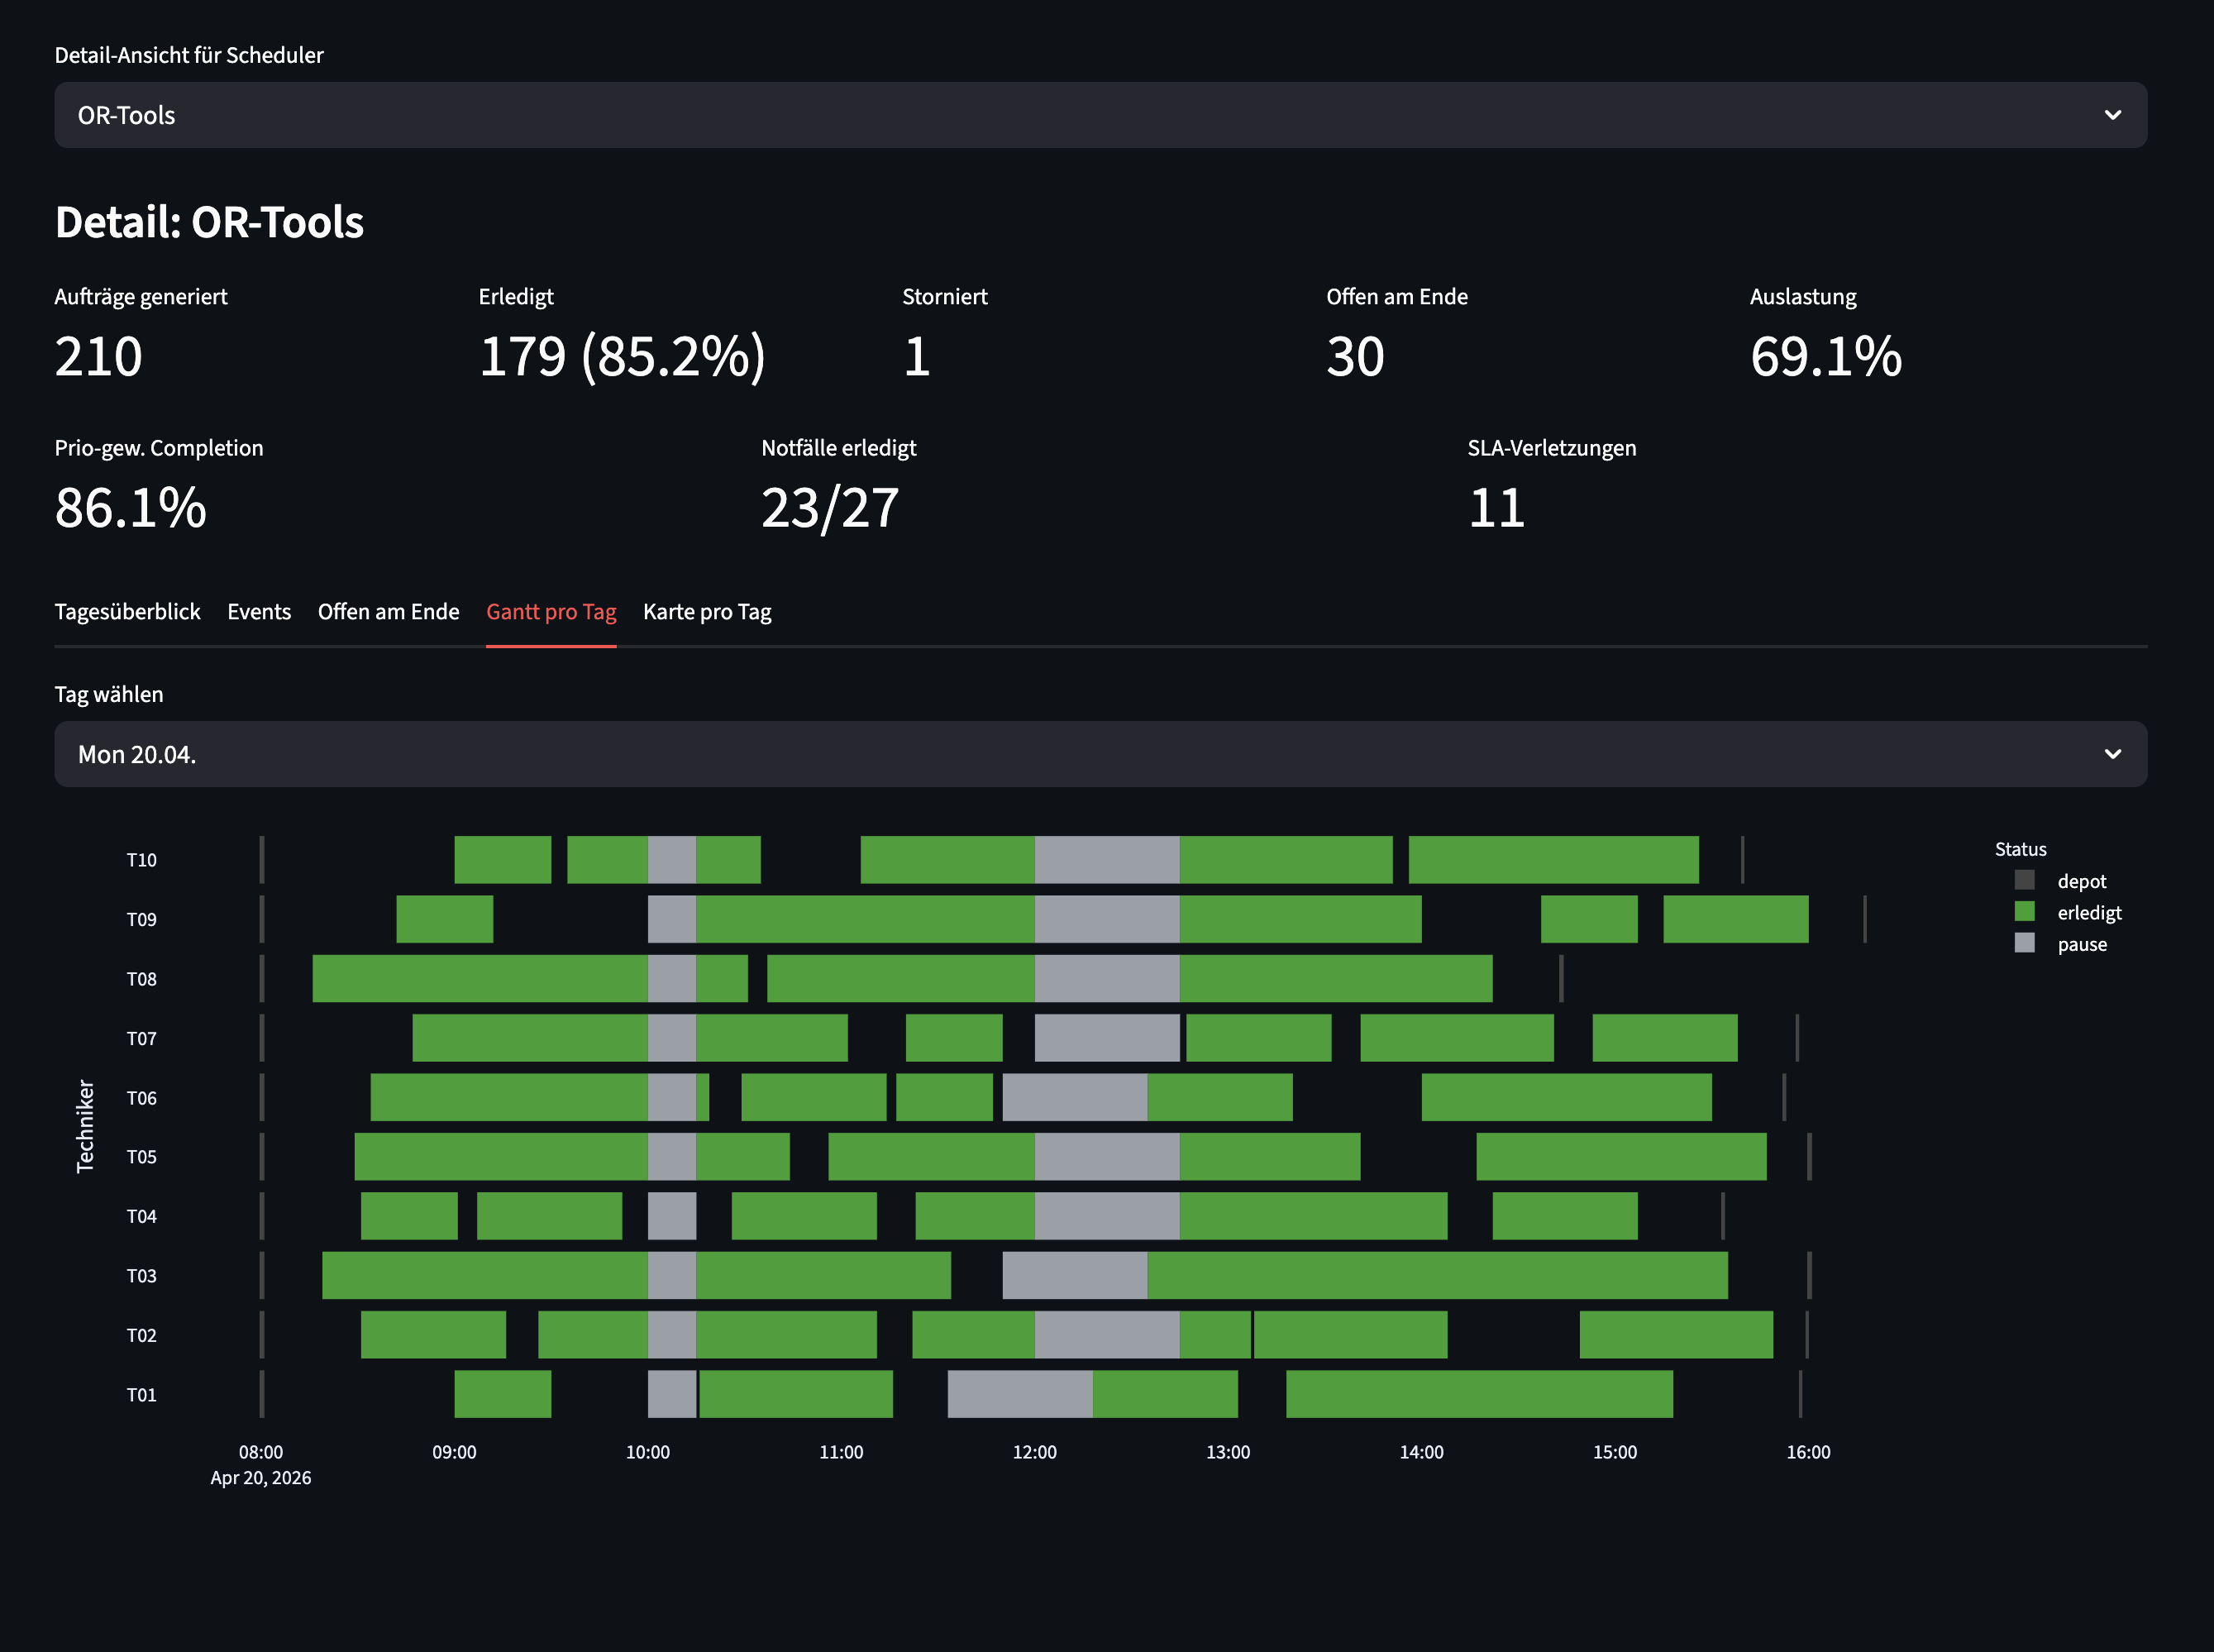
Gantt-Chart pro Tag
Zeigt jeden Techniker als eigene Zeile, farblich unterschieden nach Stop-Typ (geplant / erledigt / storniert / nicht ausgeführt / Pause / Depot). Pausen werden realistisch mitten im Auftrag dargestellt, wenn die Arbeit über die Mittagszeit läuft.
Karte pro Tag
Folium-Karte mit Betriebshof und den Touren je Techniker, farblich getrennt. Klick auf einen Stop zeigt Auftrags-ID, Kunde, Adresse und Status.
Arena: mehrere Scheduler direkt vergleichen
Multi-Select in der Sidebar wählt die Scheduler aus, die auf denselben generierten Daten laufen. Ergebnis ist eine Metrik-Tabelle plus Balkendiagramm-Vergleich über Completion, Prio-gewichtete Completion und Auslastung. Bei Hybrid werden zusätzlich Reasoning + gewählte Penalty-Gewichte angezeigt.
Benchmark ausführen
Der Multi-Seed-Benchmark reproduziert die Ergebnisse aus dem Auswertungsreport:
# Voller Lauf (alle 5 Scheduler × 20 Seeds, ~60 Min mit Hybrid)
python bench/multiseed_benchmark.py --seeds 20 --llm-model claude-sonnet-4-6

# Schneller Preview (4 Scheduler × 10 Seeds, ~25 Min)
python bench/multiseed_benchmark.py --seeds 10 --core-only

# Ohne LLM (spart API-Kosten, nur Heuristik + OR-Tools-Varianten)
python bench/multiseed_benchmark.py --seeds 20 --skip-hybrid
Rohdaten landen als CSV in bench/results_*.csv, aggregierte Kennzahlen in bench/results_*_aggregated.csv.
Projektstruktur
Einsatzplanerauswertung/
├── README.md                       # diese Datei
├── .env.example                    # Template für API-Key
├── requirements.txt
├── app.py                          # Streamlit-UI (Tag- + Wochen-Modus + Arena)
├── einsatzplaner/
│   ├── models.py                   # Dataclasses: Auftrag, Techniker, Stop, Tour, …
│   ├── generator.py                # Auftragsgenerator, Szenarioprofile, Multi-Profil-Woche
│   ├── geo.py                      # Haversine + austauschbares RouteProvider-Interface
│   ├── simulator.py                # Wochenlauf, Intraday-Event-Würfler, Replan-Trigger
│   ├── disruptions.py              # YAML-Szenario-Loader
│   ├── evaluator.py                # Metriken + Vergleichs-DataFrames
│   ├── visualization.py            # Gantt-Transformer: Pausen mitten im Auftrag
│   └── scheduler/
│       ├── base.py                 # Scheduler-Protocol, PlanInput, TechSnapshot, ReplanKontext
│       ├── heuristic.py            # Greedy-Insertion (mit Replan-Support)
│       ├── ortools_vrp.py          # OR-Tools VRPTW (mit Replan + per-Vehicle Start-Nodes)
│       ├── llm.py                  # LLM-Direct (Claude als Disponent)
│       └── hybrid.py               # LLM wählt Penalty-Gewichte, OR-Tools löst
├── scenarios/                      # YAML-Störungsszenarien (Krank, Absagen, Stau, Chaos)
├── bench/
│   └── multiseed_benchmark.py      # CLI-Benchmark für Reports
├── docs/
│   ├── auswertung.md               # Wissenschaftlicher Haupt-Report
│   └── technik.md                  # Technische Dokumentation
└── assets/
    └── title.png                   # Titelbild
Tech-Stack
- Python 3.14
- Streamlit für die UI
- Google OR-Tools (
ortools) für den VRPTW-Solver - Anthropic Claude (Sonnet 4.6 / Opus 4.6 / Haiku 4.5 wählbar) für LLM- und Hybrid-Scheduler
- Plotly / Folium für Gantt-Charts und Karten
- pytest für Tests (Infrastruktur vorbereitet, Tests aktuell Minimal)
Status
Prototyp / Forschungsprojekt. Die Ergebnisse sind reproduzierbar, aber nicht im Feld validiert. Siehe Limitationen in der Auswertung.
Lizenz
MIT — siehe LICENSE.