
SRE Lab — Plataforma de Observabilidade Kubernetes com Agents Claude
renanhermann/sre-lab
Plataforma SRE produção-ready com observabilidade, SLO e chaos testing automático
Ver no GitHubLaboratório completo de confiabilidade de sites (SRE) construído em Kubernetes com observabilidade end-to-end, SLOs formais com burn rate alerts, chaos engineering automatizado e agents Claude Code para automação operacional. Inclui stack Prometheus + Grafana + Loki, testes de injeção de falhas auto-validáveis no CI/CD e infraestrutura como código na Oracle Cloud.
Instalação
npx convez-ai renanhermann/sre-lab1 comando no terminal: detecta o formato do repositório (marketplace ou plugin avulso) e instala via Claude Code. Requer Node 18+ e o Claude Code instalado.
Métricas
Casos de uso
- Implementar e validar SLOs em clusters Kubernetes com burn rate alerts
- Automatizar detecção e resposta a incidentes com agents Claude
- Executar testes de chaos engineering integrados no CI/CD
- Demonstrar padrões de operação sênior (SLI/SLO, runbooks, GitOps)
Veredito

Projeto robusto e maduro que exemplifica SRE prático em produção, com validação automática de SLOs e integração nativa com Claude Code agents. Ideal para engenheiros que buscam referência implementada de observabilidade e confiabilidade em escala.
README
A tradução para o português deste README ainda está na fila.
SRE Lab

Laboratório pessoal de SRE com Kubernetes, observabilidade completa, SLO formal com burn rate alerts, infraestrutura como código no Oracle Cloud e agents Claude Code. Construído para demonstrar operação sênior: SLI/SLO, runbooks executáveis, GitOps, chaos engineering e cloud provisioning.
O repo é self-validating: toda mudança em código da app, manifests
SLO ou scripts de chaos dispara o workflow chaos-test no GitHub Actions,
que sobe um cluster Kubernetes do zero, aplica todos os manifests e roda
o teste de injeção de falha. Se o pipeline de detecção de incidentes
regredir, o PR é bloqueado.
Arquitetura
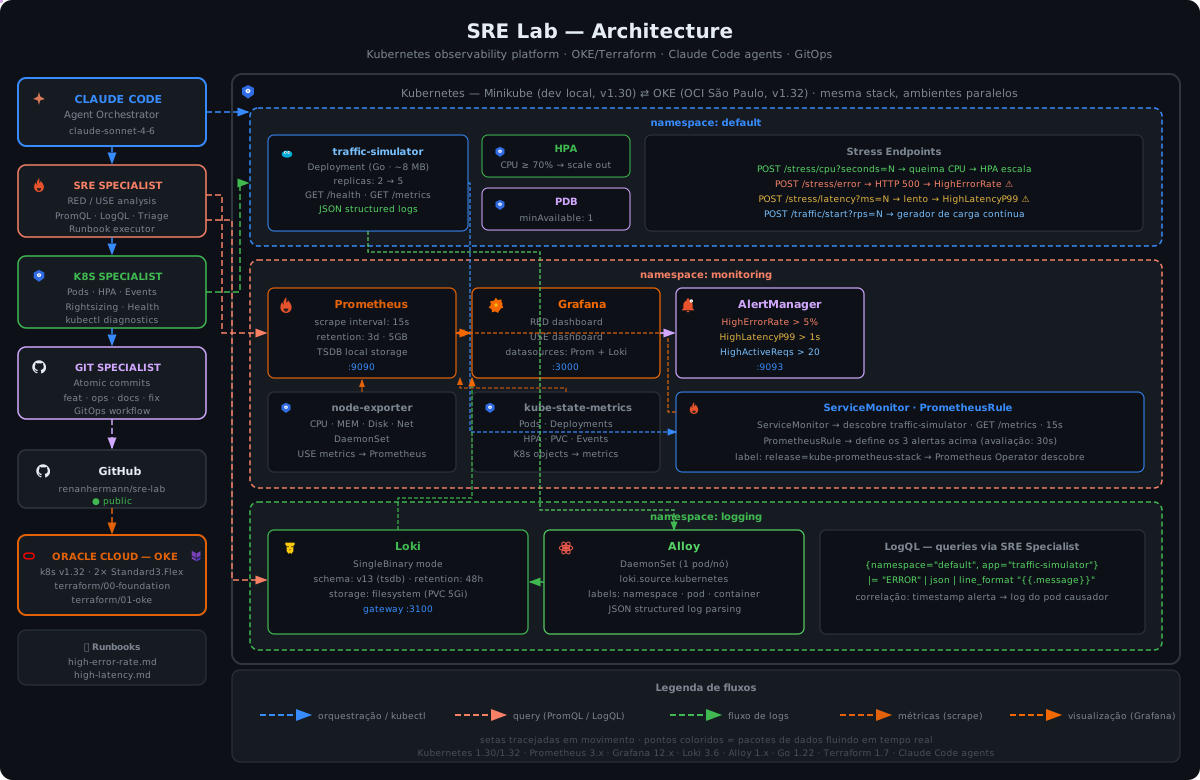
Stack
| Camada | Tecnologia |
|---|---|
| K8s local | Minikube (profile: sre-lab, driver: docker) |
| K8s cloud | Oracle Kubernetes Engine (OKE) provisionado via Terraform |
| Métricas | kube-prometheus-stack (Prometheus + Grafana + AlertManager) |
| Logs | Grafana Loki + Alloy (coleta via Kubernetes API) |
| Confiabilidade | SLO formal com error budget e burn rate multi-window/multi-burn-rate |
| App de teste | traffic-simulator — Go, ~8MB, endpoints RED + chaos primitives |
| Automação | Claude Code (agents: SRE Specialist, K8s Specialist, Git Specialist, Postmortem Specialist) |
Como subir
# Sobe o cluster Minikube
./cluster/start.sh

# Expõe os serviços localmente (manter aberto)
./cluster/expose.sh
Após o expose.sh:
| Serviço | URL | Credenciais |
|---|---|---|
| Grafana | http://localhost:3000 | admin / srelab123 |
| Prometheus | http://localhost:9090 | — |
| AlertManager | http://localhost:9093 | — |
| App de teste | http://localhost:8080 | — |
SLO formal
Dois SLOs definidos em manifests/slo/, com recording rules pré-calculadas
e quatro classes de burn rate alerts (Google SRE Workbook, cap 5):
| SLO | Target | Error budget mensal |
|---|---|---|
| Disponibilidade | 99.5% das requests | ≈ 3h36min |
| Latência | 99% das requests ≤ 500ms | ≈ 7h12min de tráfego lento |
Dashboard: SLO — traffic-simulator no Grafana.
Documento formal e playbook de validação: docs/slo.md.
Chaos test automatizado
Validação end-to-end do pipeline de SLO (recording rules → burn rate alerts → recuperação) com pass/fail determinístico:
make chaos-baseline    # ~5s   — só valida que sistema está saudável
make chaos-quick       # ~5min — fault → confirma firing (sem recovery)
make chaos-test        # ~10-15min — ciclo completo, retorna pass/fail
Documento de uso, parâmetros, códigos de saída e plano de integração CI:
docs/chaos-testing.md.
Integração contínua
O workflow chaos-test.yml executa
em todo PR que toque código da app, manifests ou scripts:
- Sobe Minikube no runner (v1.30.0, 2 CPU / 6 GB)
- Builda a imagem do
traffic-simulatorno daemon do Minikube - Instala kube-prometheus-stack com values otimizados para CI (sem Grafana, AlertManager, persistência ou dashboards de cluster)
- Aplica manifests da app e dos SLOs
- Confirma que as 24 recording rules carregaram no Prometheus
- Roda
make chaos-quick— fault injection, espera firing, valida métricas - Em caso de falha, anexa logs de pods, eventos e estado dos alertas
Tempo médio: ~10-12 minutos. Roda também no push pro main como rede de
segurança pós-merge.
Gerando carga e disparando alertas
# Inicia gerador interno (5 req/s, em loop)
curl -X POST "http://localhost:8080/traffic/start?rps=5"
curl -X POST  http://localhost:8080/traffic/stop

# Chaos primitives — disparam alertas RED do app
curl -X POST  http://localhost:8080/stress/error              # → HighErrorRate
curl -X POST "http://localhost:8080/stress/latency?ms=2000"   # → HighLatencyP99
curl -X POST "http://localhost:8080/stress/cpu?seconds=30"    # → HPA escala

# Fault injection no caminho de produção — dispara burn rate alerts do SLO
# (rate=N% de 5xx em /health por duration, auto-reset, cap 30min)
curl -X POST "http://localhost:8080/admin/fault?rate=40&duration=10m"
curl -X POST "http://localhost:8080/admin/fault?rate=0"       # desativa
Observação importante: /stress/* são endpoints de chaos explícitos e
não consomem error budget (excluídos do SLI via path !~ "/stress/.*").
Já /admin/fault injeta falha em /health — caminho de produção — e
portanto consome budget de verdade. Ver docs/slo.md §6 pro playbook
completo de validação.
Agents Claude Code
| Agent | Responsabilidade |
|---|---|
sre-specialist | Analisa RED (Rate/Errors/Duration) + USE, consulta Prometheus e Loki, gera relatório com causa raiz |
k8s-specialist | Monitora pods, HPA, eventos, uso de recursos e recomenda rightsizing |
git-specialist | Commits atômicos, branches por feature, histórico GitOps limpo |
postmortem-specialist | Gera draft de postmortem a partir de janela de tempo + nome do incidente — consulta Prom, Loki e eventos K8s, marca fato vs hipótese |
Runbooks
- HighErrorRate — erro rate > 5% por 1 minuto
- HighLatencyP99 — P99 > 1s por 2 minutos
- SLO Burn Rate — resposta a alertas de SLO
Postmortems
Postmortems blameless de incidentes (reais ou simulados via chaos test).
- TEMPLATE — formato Google SRE Workbook em pt-BR
- README — como gerar via
postmortem-specialist, naming convention, checklist de revisão
Oracle Cloud (OKE)
Infraestrutura como código em terraform/, dividida por responsabilidade
(padrão do eks-stack pessoal):
terraform/00-foundation/— VCN, gateways, route tables, security lists, subnetsterraform/01-oke/— cluster OKE + node pool (Standard3.Flex, 2 OCPUs/8GB)
# Sobe
cd terraform/00-foundation && terraform apply -auto-approve
cd ../01-oke && terraform apply -auto-approve
oci ce cluster create-kubeconfig --cluster-id $(terraform output -raw cluster_id) \
  --file ~/.kube/config-oci --region sa-saopaulo-1 --token-version 2.0.0

# Destrói (economiza crédito do free trial)
./terraform/destroy-cluster.sh
Estrutura
sre-lab/
├── app/                  # traffic-simulator em Go
│   ├── main.go           # servidor HTTP + métricas RED + chaos primitives
│   ├── Dockerfile        # multi-stage build (scratch ~8MB)
│   └── go.mod
├── .github/workflows/    # chaos-test.yml — CI que valida o pipeline SLO em PR
├── cluster/              # start.sh + expose.sh do Minikube
├── helm/                 # values: kube-prom-stack (local + CI), loki, alloy
│   └── oke/              # values adaptados pra OKE (StorageClass oci-bv, ClusterIP)
├── manifests/
│   ├── app/              # Deployment, Service, HPA, PDB, ServiceMonitor, PrometheusRule
│   ├── slo/              # SLO availability + latency + dashboard Grafana
│   └── oke/              # deployment do app adaptado pro OCIR + ImagePullSecret
├── scripts/
│   ├── chaos-test.sh     # validação automatizada do pipeline de SLO
│   └── lib/              # log, prom, app helpers
├── Makefile              # make help — atalhos de cluster/app/SLO/chaos
├── terraform/
│   ├── 00-foundation/    # VCN e network
│   ├── 01-oke/           # cluster OKE
│   └── destroy-cluster.sh
├── docs/
│   ├── architecture.svg  # diagrama da arquitetura
│   ├── slo.md            # SLO formal: definições, burn rate, error budget policy
│   ├── chaos-testing.md  # validação automatizada do pipeline de SLO
│   ├── oke-deployment.md # guia ponta a ponta da replicação Minikube → OKE
│   └── runbooks/         # runbooks executáveis por agent
└── .claude/agents/       # definições dos agents Claude Code
Roadmap
- Fase 1 — Cluster local + observabilidade (Prometheus, Loki, Grafana, Alloy)
- Fase 1 — App de teste em Go com métricas RED e endpoints de stress
- Fase 1 — Alertas, HPA, PDB e runbooks operacionais
- Fase 1 — Agents Claude Code (SRE, K8s, Git Specialist)
- Fase 2 — Provisionamento OKE no Oracle Cloud via Terraform
- Fase 3 — SLO formal com error budget e burn rate alerts (4 janelas)
- Fase 3 — Chaos primitive
/admin/faultpara validar SLO - Fase 3 — Dashboard Grafana de SLO (ConfigMap auto-importado)
- Fase 4 — Chaos test automatizado (
make chaos-test, validação end-to-end) - Fase 4 — Workflow GitHub Actions executando chaos test em PR
- Fase 4 — Postmortem automatizado via
postmortem-specialistagent - Fase 4 — Replicar stack Minikube no OKE (Helm + manifests + SLO + chaos test) — ver docs/oke-deployment.md
- Fase 5 — Ingress-nginx + LB free OCI + cert-manager + Let's Encrypt (Grafana em URL pública HTTPS) — ver docs/ingress-https.md
- Fase 6 — FinOps: OpenCost + custom OCI pricing + dashboard + 5 budget alerts — ver docs/finops.md