
Platform de Auditoria Estatística Automatizada
eliezermoise63-glitch/stat-audit-platform
Auditoria estatística automatizada com IA para interpretação de resultados
Ver no GitHubPipeline completo de análise estatística com ingestion multi-fonte (CSV, SQLite, URL), limpeza de dados, detecção automática de tipos de variáveis e análises multivariadas (ACP, Análise Fatorial, ACM, AFDM). Integra interpretação por LLM via Claude para síntese de insights em linguagem natural.
Instalação
npx convez-ai eliezermoise63-glitch/stat-audit-platform1 comando no terminal: detecta o formato do repositório (marketplace ou plugin avulso) e instala via Claude Code. Requer Node 18+ e o Claude Code instalado.
Métricas
Casos de uso
- Validação e limpeza de datasets antes de análise
- Exploração multivariada de dados sem código estatístico manual
- Síntese automática de insights estatísticos em linguagem de negócio
- Detecção de correlações, componentes principais e padrões latentes
Veredito

Ferramenta robusta para profissionais que precisam automatizar análises estatísticas complexas. A integração com Claude agrega valor ao transformar resultados técnicos em narrativas acionáveis, apesar de exigir conhecimento prévio de estatística multivariada.
README
A tradução para o português deste README ainda está na fila.
Statistical Audit Platform
Plateforme d'audit statistique automatisée : chargement multi-source (CSV, SQLite, URL), nettoyage de données, détection automatique des types de variables, analyse multivariée (ACP, AF, ACM, AFDM) et interprétation par LLM via Claude (Anthropic).
Demo live : https://stat-audit-eliezer.streamlit.app GitHub : https://github.com/eliezermoise63-glitch/stat-audit-platform




Aperçu
Ce que fait ce projet
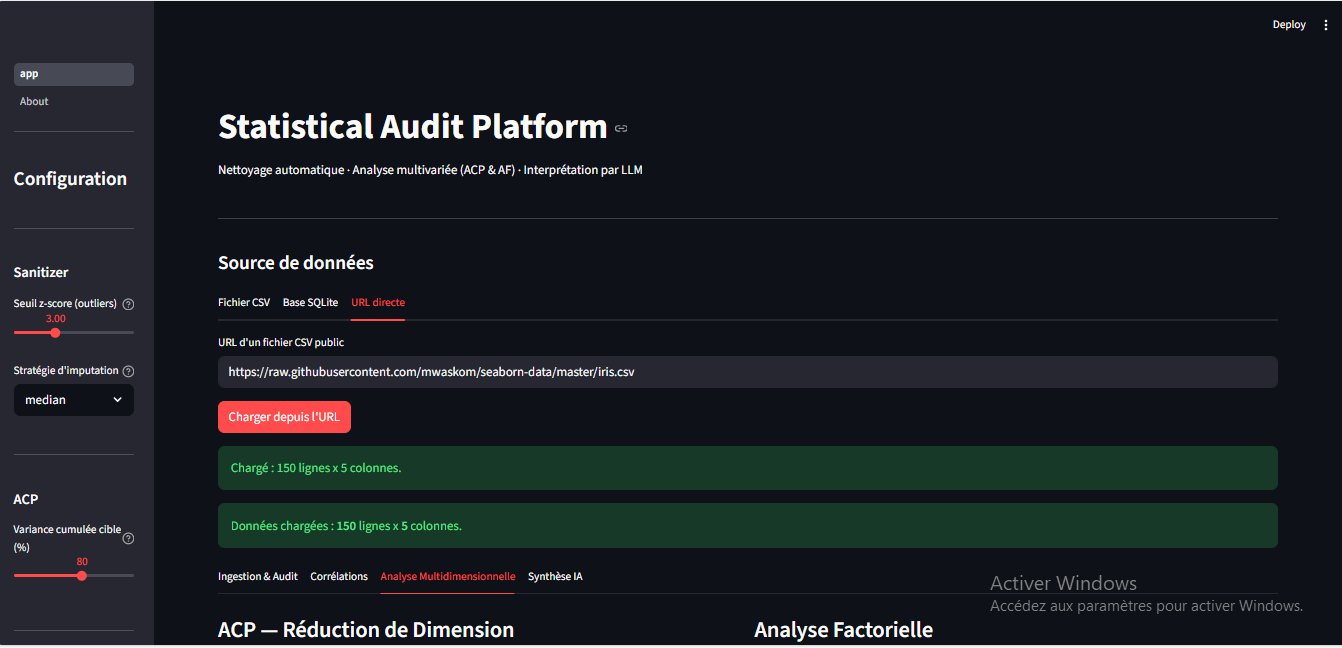
Quelle que soit la source de données choisie (CSV, SQLite ou URL), le pipeline de traitement est identique — la source est abstraite dès l'ingestion en un DataFrame pandas.
| Etape | Module | Ce qui se passe |
|---|---|---|
| 1. Ingestion multi-source | app.py | CSV upload, base SQLite avec requête SQL personnalisée, ou URL directe |
| 2. Fiabilisation | core/sanitizer.py | Suppression colonnes constantes, imputation médiane, suppression outliers z-score |
| 3. Détection des types | core/detector.py | Classification automatique : continue, catégorielle, binaire, ignorée |
| 4. Corrélations | core/engine.py | Shapiro-Wilk → choix automatique Pearson ou Spearman, p-values |
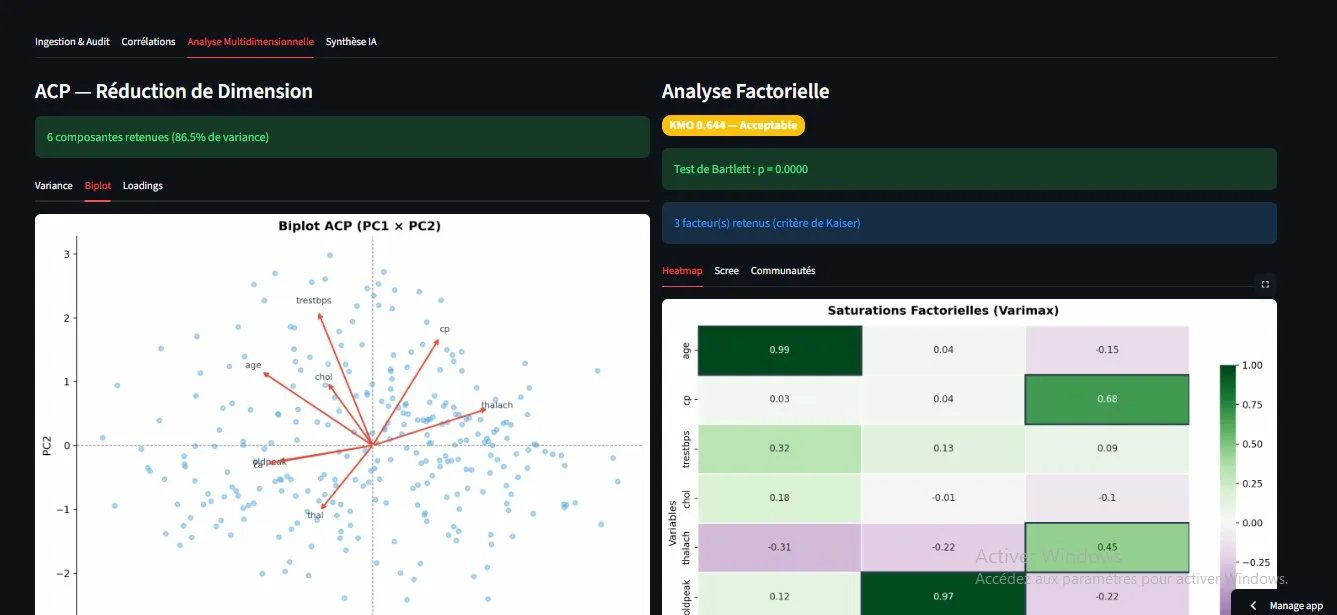
| 5. ACP | core/engine.py | Sélection automatique des composantes, biplot, loadings, top variables |
| 6. Analyse Factorielle | core/engine.py | KMO + Bartlett, Kaiser, rotation Varimax ou Promax, communautés |
| 7. ACM | core/engine.py | Analyse des Correspondances Multiples (variables catégorielles) via prince |
| 8. AFDM | core/engine.py | Analyse Factorielle des Données Mixtes (dataset mixte) via prince |
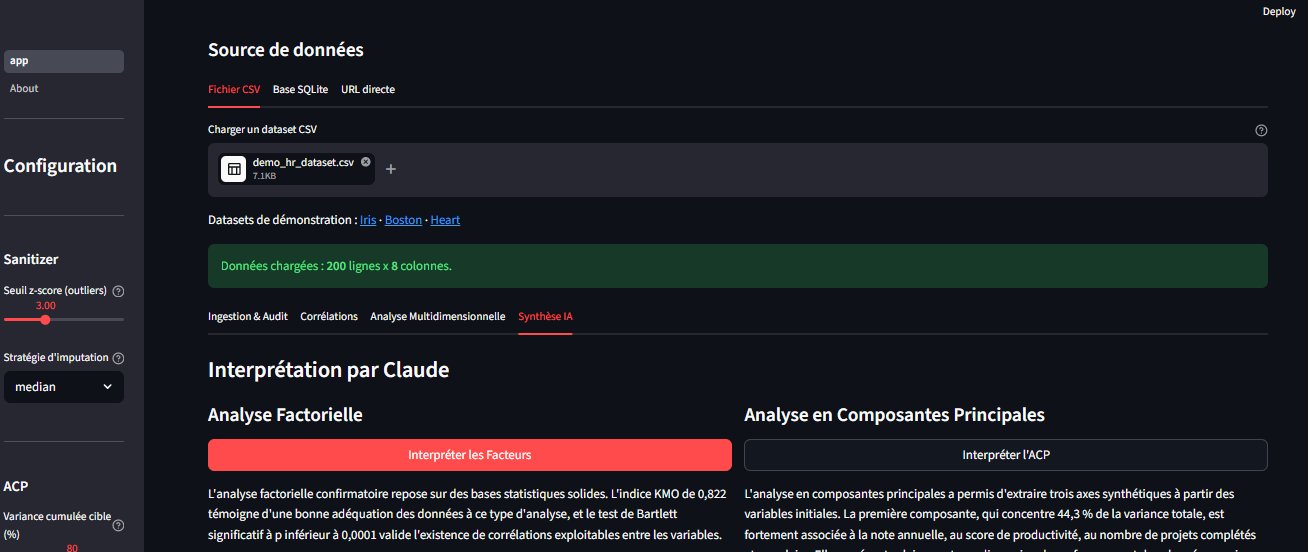
| 9. Synthèse LLM | utils/llm.py | Prompts structurés vers Claude pour interprétation métier en langage naturel |
Fonctionnalités clés
- Chargement multi-source : fichier CSV, base SQLite avec requête SQL personnalisée, URL directe
- Nettoyage automatique : valeurs manquantes, outliers, variables non informatives
- Détection automatique des types de variables : continue, catégorielle, binaire (seuil configurable)
- ACP avec sélection automatique du nombre de composantes (seuil de variance configurable)
- Analyse Factorielle validée statistiquement (KMO, Bartlett) avec rotation Varimax ou Promax
- ACM (Analyse des Correspondances Multiples) pour les variables catégorielles
- AFDM (Analyse Factorielle des Données Mixtes) pour les datasets mixtes
- Corrélation automatique Pearson/Spearman selon test de normalité Shapiro-Wilk
- Interprétation en langage naturel par Claude — séparation claire entre inférence statistique et LLM
- Interface interactive Streamlit avec configuration en temps réel (sidebar)
- 53 tests unitaires et d'intégration, CI/CD GitHub Actions
Sources de données supportées
Fichier CSV
Upload direct depuis votre machine. Séparateur auto-détecté (virgule, point-virgule, tabulation).
Base SQLite
Uploadez un fichier .db ou .sqlite, l'app liste automatiquement les tables disponibles et vous permet d'écrire une requête SQL personnalisée.
-- Exemples de requêtes
SELECT * FROM employes
SELECT age, salaire, satisfaction FROM employes WHERE anciennete > 2
SELECT * FROM clients LIMIT 500
Pour générer une base SQLite de démonstration :
python assets/demo_data_generator.py --sqlite
URL directe
Collez une URL pointant vers un fichier CSV public. Exemples :
- https://raw.githubusercontent.com/mwaskom/seaborn-data/master/iris.csv
- https://raw.githubusercontent.com/selva86/datasets/master/BostonHousing.csv
- https://raw.githubusercontent.com/sharmaroshan/Heart-UCI-Dataset/master/heart.csv
Démarrage rapide
Prérequis : Python 3.10 ou supérieur. Clé API Anthropic optionnelle (onglet Synthèse IA uniquement).
git clone https://github.com/eliezermoise63-glitch/stat-audit-platform.git
cd stat-audit-platform

python -m venv .venv
source .venv/bin/activate      # Linux/macOS
# .venv\Scripts\activate       # Windows

pip install -r requirements.txt
streamlit run app.py
Configuration de la clé API :
cp .streamlit/secrets.toml.example .streamlit/secrets.toml
# Editez .streamlit/secrets.toml :
# ANTHROPIC_API_KEY = "sk-ant-votre-cle-ici"
Sans clé : les 3 premiers onglets fonctionnent normalement. Seul l'onglet Synthèse IA est désactivé.
Architecture
stat-audit-platform/
├── app.py                      # Point d'entrée Streamlit (4 onglets)
├── core/
│   ├── sanitizer.py            # Pipeline de fiabilisation des données
│   ├── detector.py             # Détection automatique des types de variables
│   └── engine.py               # ACP · AF · ACM · AFDM · Corrélations
├── utils/
│   ├── charts.py               # Visualisations matplotlib/seaborn
│   └── llm.py                  # Interface Claude (Anthropic)
├── assets/
│   └── demo_data_generator.py  # Génère CSV et SQLite de démonstration
├── tests/                      # 53 tests unitaires et d'intégration
└── .github/workflows/ci.yml    # CI GitHub Actions (Python 3.10 et 3.11)
Détails techniques
DataSanitizer
Source (CSV / SQLite / URL)
    -> DataFrame pandas (abstraction commune)
    -> Sélection colonnes numériques
    -> Suppression colonnes constantes (nunique <= 1)
    -> Imputation médiane robuste
    -> Suppression colonnes quasi-constantes (ratio < 1% sur valeurs non-nulles)
    -> Suppression lignes outliers (|z-score| > seuil configurable, défaut 3)
DataFrame fiabilisé + SanitizationReport traçable
VariableDetector
DataFrame fiabilisé
    -> Non numérique                    → ignorée
    -> n_unique <= 1                    → ignorée (constante)
    -> n_unique == 2                    → binaire
    -> n_unique / n_rows < seuil (5%)  → catégorielle
    -> n_unique < min_unique (10)       → ignorée (quasi-constante)
    -> sinon                            → continue
DetectionReport : continues / catégorielles / ignorées / is_mixed
MultivariateEngine
ACP : standardisation obligatoire (StandardScaler), sélection automatique des composantes par variance cumulée (seuil configurable, défaut 80%), biplot PC1 × PC2, top-N variables par composante.
Analyse Factorielle : validation KMO (seuil 0.6) et test de Bartlett (p < 0.05), critère de Kaiser pour le choix automatique du nombre de facteurs, rotation Varimax (orthogonale) ou Promax (oblique), rapport de communautés par variable.
Corrélations : test de normalité Shapiro-Wilk sur chaque variable → Pearson si toutes normales, Spearman sinon. P-values calculées par symétrie (triangle supérieur uniquement).
ACM : variables catégorielles converties en chaînes, analyse via prince.MCA, coordonnées individus et modalités, tableau d'inertie par composante.
AFDM : dataset mixte (continues + catégorielles) analysé via prince.FAMD, espace factoriel commun, coordonnées variables et modalités sur les mêmes axes.
SQLAlchemy
La connexion SQLite utilise SQLAlchemy 2.0. pd.read_sql() retourne un DataFrame identique à pd.read_csv() " le pipeline en aval ne fait aucune différence entre les sources".
Limites actuelles
| Limite | Impact | Priorité |
|---|---|---|
| factor-analyzer incompatible avec scikit-learn >= 1.6 | Contournement en place (sklearn épinglé < 1.6) | Haute |
| SQLite uniquement (pas PostgreSQL, MySQL) | Bases distantes non supportées | Moyenne |
| Pas de cache Streamlit | Recalcul à chaque interaction | Moyenne |
| Rapport non exportable | Résultats non persistants | Basse |
Roadmap
Court terme (v0.3) :
- Compatibilité scikit-learn >= 1.6
- Support PostgreSQL et MySQL via SQLAlchemy
- Cache Streamlit (
@st.cache_data) - Export PDF du rapport
- Prompts LLM pour ACM et AFDM
Moyen terme (v0.4) :
- Clustering post-ACP : K-Means sur les composantes principales, choix automatique de K par méthode du coude et silhouette score
- KNN Imputer en alternative à la médiane
- Isolation Forest en complément du z-score
Long terme (v1.0) :
- DBSCAN pour clusters de forme arbitraire
- Rapport automatique avec interprétation LLM incluse
- Comparaison de datasets avant/après traitement
Tests
pytest tests/ -v
pytest tests/ --cov=core --cov=utils --cov-report=term-missing
Déploiement sur Streamlit Cloud
- Pusher ce dépôt sur GitHub
- Aller sur share.streamlit.io
- Create app -> sélectionner ce repo -> fichier principal : app.py
- Advanced settings -> Secrets -> ajouter ANTHROPIC_API_KEY
- Deploy
Pitch (30 secondes)
"J'ai développé une plateforme d'audit statistique automatisée. Elle accepte trois sources de données : fichier CSV, base SQLite avec requête SQL personnalisée, et URL directe. Elle détecte automatiquement le type de chaque variable " continue, catégorielle ou binaire " et applique la méthode adaptée : ACP et Analyse Factorielle pour les variables continues, ACM pour les catégorielles, AFDM pour les datasets mixtes. L'interprétation des résultats est assurée par Claude via l'API Anthropic."
Licence
MIT - Eliezer Moise